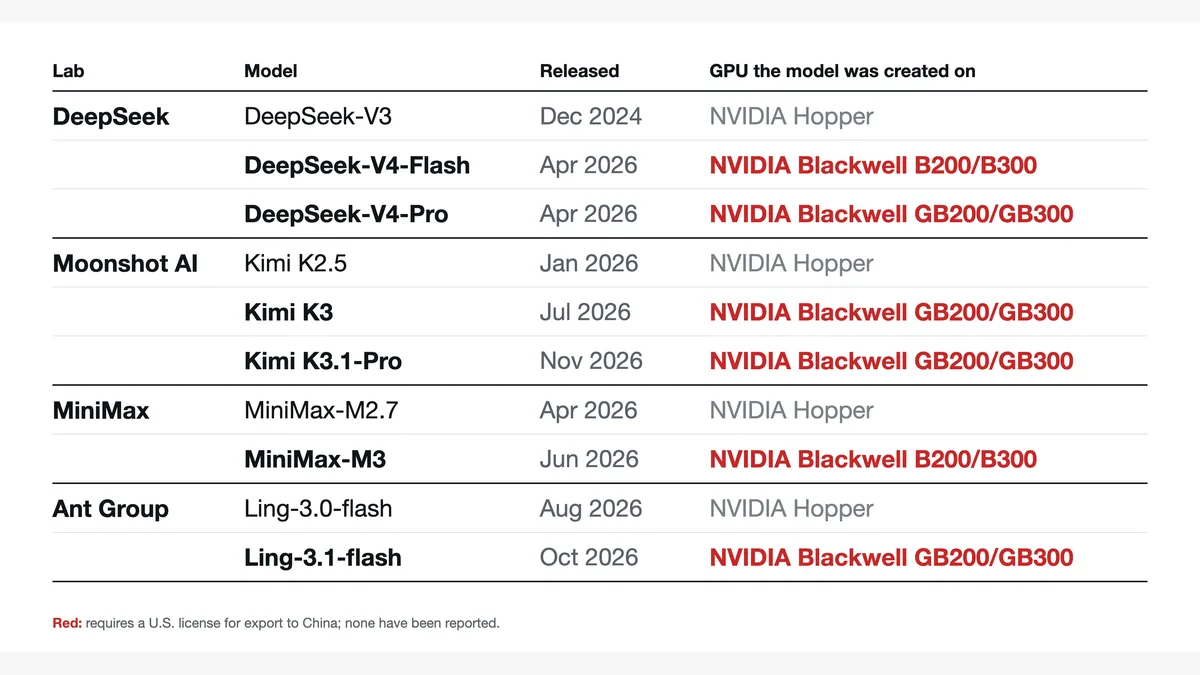
중국 주요 AI 모델 6개에서 중국 수출이 제한된 엔비디아(NVIDIA) 블랙웰(Blackwell) GPU와 일치하는 수치 흔적이 발견됐다. 윌 드퓌(Will DePue)는 딥시크(DeepSeek), 문샷 AI(Moonshot AI), 미니맥스(MiniMax), 앤트그룹(Ant Group)이 공개한 모델의 가중치를 분석해 이 결과를 발표했다. 내부 제보가 아니라 누구나 내려받을 수 있는 모델의 숫자에서 하드웨어 사용 단서를 찾아냈다는 점이 눈길을 끈다. 다만 흔적이 가리키는 것은 모델의 초기값을 만든 하드웨어다. 실제 학습 장소와 GPU를 확보한 경로는 이 분석만으로 알 수 없다.
핵심요약
- 윌 드퓌는 중국 기업 4곳의 모델 6개에서 블랙웰 GPU의 작업 배치와 맞는 흔적을 찾아, 공개 가중치만으로 하드웨어 접근을 추적할 수 있음을 보였다.
- 이전 모델에는 호퍼(Hopper) 세대의 흔적이 나타나고 최신 모델에는 블랙웰 흔적이 나타나, 일부 기업의 모델 제작 환경이 바뀐 정황을 제시한다.
- 분석법은 난수 씨앗과 GPU의 병렬 작업 배치를 함께 대조하며, 실제 GPU 재현과 별도로 남겨 둔 가중치 검증으로 우연한 일치 가능성을 낮췄다.
- 이 흔적은 초기값을 만든 장치를 가리킬 뿐 전체 학습에 쓰인 GPU나 그 소재지를 증명하지 않으므로, 수출 통제 위반 여부와는 구분해야 한다.
- 연구진은 대형 학습에 수천 장의 블랙웰 GPU가 필요했을 것으로 추정했지만, 학습 기간과 GPU 활용률 등 공개되지 않은 조건에 따라 규모는 크게 달라진다.
최신 모델 6개에 나타난 블랙웰 흔적
드퓌가 발표한 분석에서 블랙웰과 일치한 모델은 딥시크-V4-Flash와 V4-Pro, 문샷 AI의 키미(Kimi) K3와 K3.1-Pro, 미니맥스-M3, 앤트그룹의 링(Ling)-3.1-flash다. 이 가운데 V4-Flash와 M3는 연산 단위인 SM(스트리밍 멀티프로세서)이 148개인 B200·B300 계열의 배치와 맞았다. 나머지 네 모델은 SM이 152개인 GB200·GB300 계열과 맞았으며, 이 방식으로는 같은 계열 안의 개별 칩까지 구별할 수 없다.
기업별 이전 모델과 나란히 놓으면 변화가 더 분명해진다. 딥시크는 2024년 12월 공개한 V3까지 호퍼 배치를 보이다가 2026년 4월 공개한 V4부터 블랙웰 배치를 보였고, 문샷 AI는 2026년 1월의 키미 K2.5까지 호퍼였다가 7월의 K3부터 달라졌다. 미니맥스는 2026년 4월의 M2.7과 6월의 M3 사이에서, 앤트그룹은 8월의 링-3.0-flash와 10월의 링-3.1-flash 사이에서 흔적이 바뀌었다. 다만 호퍼 흔적만으로는 H800, H100 SXM, H200 중 어느 칩이 쓰였는지 판별할 수 없다.
변화가 모든 중국 AI 기업에 공통으로 나타난 것은 아니다. 분석 가능한 알리바바(Alibaba)의 큐원(Qwen), 지푸(Zhipu)의 GLM, 텐센트(Tencent), 샤오미(Xiaomi), 스텝펀(StepFun)의 최신 모델에서는 호퍼 흔적이 나왔다. 메이퇀(Meituan)은 롱캣(LongCat)-2.0을 AI 전용 반도체 시스템에서 학습시켰다고 밝혔고, 공개된 가중치에서도 엔비디아 흔적이 발견되지 않았다. 흔적이 없다는 결과와 특정 GPU를 쓰지 않았다는 결론은 다르다는 점도 이 비교에서 중요하다.
공개 가중치로 거꾸로 찾은 제작 환경
모델 가중치(답을 만드는 방식을 결정하는 조정 가능한 숫자)는 학습이 시작되기 전에 먼저 초기값을 받아야 한다. 이번 분석의 대상 소프트웨어는 필록스(Philox)라는 의사난수 생성 알고리즘으로 그 값을 만들며, 같은 씨앗값과 설정을 넣으면 같은 숫자가 다시 나온다. 파이토치(PyTorch)는 이 작업을 빠르게 처리하려고 GPU의 여러 스레드(병렬로 일하는 작업 단위)에 나눠 맡긴다. GPU에 연산 단위가 몇 개 있느냐에 따라 같은 숫자라도 가중치의 어느 자리에 놓이는지가 달라진다.
간단히 말해 씨앗값이 숫자의 순서를 정하고, 하드웨어의 작업 배치가 그 숫자의 위치를 정한다. 씨앗값만 맞고 스레드 수가 다르면 같은 숫자가 엉뚱한 자리에 놓이며, 배치만 맞고 씨앗값이 다르면 숫자 자체가 달라진다. 연구진이 조사한 설정에서 호퍼의 SM 132개는 스레드 27만336개, 블랙웰의 SM 148개는 30만3104개, SM 152개는 31만1296개를 사용한다. 드퓌는 씨앗값과 배치를 함께 바꿔 보며 공개 가중치에 남은 초기 배열을 재현했다.
학습 뒤에도 남은 초기값의 자취
학습은 초기 가중치를 계속 고치지만, 모든 숫자를 똑같이 바꾸지는 않는다. 학습 중 쓰이지 않은 단어나 기호를 위해 남겨 둔 가중치는 초기값을 거의 그대로 보존할 수 있다. 반대로 값이 바뀐 부분에서도 처음에 큰 값이었던 가중치가 최종적으로도 상대적으로 큰 경향을 보이면 약한 흔적을 찾을 수 있다. 연구진은 수많은 가중치를 함께 비교해 이런 관계가 후보 씨앗값과 배치에서 나타나는지 살폈다.
찾아낸 조합을 같은 데이터에만 다시 맞춰 보는 데 그치지 않은 것도 핵심이다. 연구진은 일부 가중치로 씨앗값과 배치를 고른 뒤, 탐색에 쓰지 않은 다른 가중치의 초기값을 그 조합으로 예측했다. 딥시크-V3는 호퍼 배치와, V4-Flash는 블랙웰 148개 SM 배치와, 키미 K3는 블랙웰 152개 SM 배치와 맞았다. 학습된 가중치에 남은 관계는 모든 모델에서 반드시 살아남는 성질이 아니므로, 이 방법이 적용되는 범위는 모델마다 다르다.
블랙웰 흔적이 말해 주지 않는 것
이 분석은 가중치를 공개한 모델에만 적용할 수 있고, 초기값 생성 소프트웨어가 하드웨어별 배치 차이를 남겨야 한다. 바이두(Baidu)의 어니(ERNIE)-5.5에서는 씨앗값 2760을 찾았지만, 모델에 쓰인 프레임워크가 칩 배치를 흔적으로 남기지 않아 초기화 하드웨어를 알아내지 못했다. CPU에서 초기값을 만든 일부 큐원 모델에서도 GPU 흔적은 남지 않는다. 딥시크-V4.1-Flash 역시 면밀히 검색했지만 흔적을 찾지 못했다.
더 큰 한계는 초기화와 학습이 같은 일이라는 보장이 없다는 점이다. 한 장치에서 가중치의 시작값을 만든 뒤 다른 GPU로 옮겨 학습할 수 있고, 기존 모델을 새 하드웨어에서 이어 학습할 수도 있다. 여러 종류의 칩을 섞은 환경이라면 초기값을 만든 엔비디아 GPU의 흔적은 남아도 나중에 학습에 참여한 다른 칩은 드러나지 않을 수 있다. 따라서 블랙웰과 맞는 배열은 접근의 강한 단서지만, 전체 학습이 블랙웰에서 진행됐다는 기록은 아니다.
칩이 어디에 있었는지도 가중치에는 적혀 있지 않다. 중국 밖 데이터센터에서 시스템을 빌려 썼을 가능성과 중국 안에서 사용했을 가능성을 이 방식으로 구별할 수 없다. 블랙웰 계열 칩을 중국으로 수출하려면 미국의 허가가 필요하지만, 연구진의 결과만으로 칩의 이동 경로나 수출 통제 위반을 판단할 수는 없다. 모델이 공개된 날짜 역시 해당 하드웨어를 언제 확보했는지 알려 주지 않는다.
AMD 가능성을 좁힌 숫자 차이
블랙웰과 맞는 작업 배치가 오직 엔비디아 칩에서만 나오는지도 따져야 한다. 조사 대상인 이전 세대 엔비디아 칩에는 블랙웰 배치에 필요한 만큼의 연산 단위가 없어, 분석에서 사용한 표준 파이토치 동작으로는 같은 배열을 만들 수 없다. 하지만 AMD의 MI300X는 연산 단위를 특수하게 제한하면 SM 148개 또는 152개에 해당하는 배치를 재현할 수 있다. 연구진도 실제 MI300X에서 이 가능성을 확인했다.
드퓌는 배치가 아닌 생성된 숫자 자체의 미세한 차이로 두 제조사의 결과를 다시 비교했다. 딥시크-V4-Flash의 보존된 가중치 가운데 AMD와 엔비디아의 생성값이 다른 377곳을 살펴보니, 공개 가중치는 363곳에서 엔비디아 값과 맞았고 AMD 값과 맞은 곳은 없었다. 다른 다섯 모델에서는 이 검사만으로 제조사를 확정하지 못했다. 연구진은 이들까지 AMD로 설명하려면 클러스터 전체를 블랙웰과 같은 연산 단위 수로 이례적으로 설정해야 한다며 그 가능성을 낮게 봤다.
실제 GPU와 대조한 결과
연구진은 딥시크 모델에서 찾은 씨앗값 953049583을 수정하지 않은 파이토치에 넣고 실제 H100과 B300에서 초기값을 만들었다. H100은 V3의 보존된 값 5만7344개를 모두 비트 단위로 재현했지만 V4-Flash의 해당 값은 재현하지 못했다. B300에서는 V4-Flash의 선택된 가중치 행 469개 중 461개가 0.99를 넘는 상관관계를 보였고, 그중 445개 행 전체가 비트 단위로 일치했다. 두 GPU 모두 반대편 모델의 보존된 행은 재현하지 못했으며, 씨앗값을 1만 바꿔도 일치는 사라졌다.
문샷 AI의 씨앗값 20256586을 사용한 GB200에서는 키미 K3의 보존된 행 13개가 모두 재현됐다. 연구진이 확인한, 개발사가 특정 모델의 하드웨어를 공개한 사례 24건에서도 분석 결과는 공개 내용과 일치했다. 다만 그중에는 학습 시작 시점의 체크포인트(저장된 모델 상태) 11건이 있고 서로 연관된 모델도 있어, 24건을 독립적인 정확도 시험 결과로 읽어서는 안 된다. 재현에 필요한 코드와 보존된 가중치는 공개돼 있으며, GPU 없이 비교하는 검사도 가능하다.
우연한 일치 문제도 별도로 계산했다. 씨앗값과 배치의 조합을 약 6조 개 탐색하면 아무 관계가 없어도 높은 점수가 나올 기회가 생겨, 연구진은 전체 탐색에서 우연히 나타날 수 있는 수준을 약 8시그마(무작위 변동에서 얼마나 떨어졌는지를 나타내는 값)로 잡았다. 여섯 모델의 가장 강한 결과는 각각 49~1385시그마였고, 보고한 개별 검사 중 가장 낮은 값도 20시그마였다. 이는 초기 배열의 일치가 우연히 나왔다는 설명을 약하게 만들지만, 그 배열을 만든 장치가 학습 전 과정도 맡았는지는 별개의 질문으로 남는다.
수천 장 추정에 붙은 조건
드퓌는 모델 크기와 학습 데이터량을 바탕으로 키미 K3와 딥시크-V4-Pro의 최종 학습에 각각 수천 장의 블랙웰 GPU가 두세 달간 필요했을 것으로 추정했다. 가장 그럴듯한 값으로는 각각 약 4500장과 3000장을 제시했고, 다섯 차례의 학습을 합치면 약 1만2000장으로 계산했다. 키미 K3.1-Pro는 K3와 같은 씨앗값에서 출발해 추가 학습된 체크포인트일 수 있어 별도 대형 학습으로 세지 않았다. 이 숫자는 초기값을 만든 하드웨어에서 최종 학습도 진행했다는 가정 위에 놓여 있다.
비용은 블랙웰 GPU 한 장당 약 7만 달러라는 보도 기반 가격을 적용해, 가장 큰 클러스터가 약 2억~3억 달러에 이를 것으로 추산했다. 그러나 각 기업은 이번 학습의 실제 GPU 활용률과 소요 기간을 공개하지 않았고, 일부 학습 데이터량도 연구진의 추정치다. 특히 학습 기간을 절반으로 잡으면 필요한 GPU 수는 두 배가 된다. 연구진은 당초 발표한 더 낮은 추정치를 실제 블랙웰 학습 사례의 효율을 반영해 상향 수정했으며, 현재 수치에도 확신이 높지 않다고 밝혔다.
커뮤니티 의견
한 사용자는 중국 기업이 중국 밖 데이터센터의 GPU를 원격으로 빌려 쓰는 길이 있다고 지적했다. 싱가포르나 말레이시아에 있는 칩을 사용했다면 모델에서 블랙웰 흔적이 발견돼도 칩이 중국으로 수출됐다는 뜻은 아니라는 주장이다. 이 의견은 하드웨어 접근과 수출 통제 위반을 구분해야 한다는 보고서의 한계와 맞닿아 있다.
또 다른 사용자는 글의 신뢰성을 검증하기 전에 작성자의 성향이나 경력을 근거로 결론을 받아들이지 말자고 주장했다. 이에 대한 답글에서는 작성자를 다른 인물과 혼동한 것 아니냐는 지적이 나왔다. 보고서가 공개한 재현 코드와 검사 결과를 살피는 일과 작성자에 대한 주장을 확인하는 일은 구분해서 봐야 한다는 논쟁이었다.
한 사용자는 수출 통제 문제보다 공개 가중치 모델이 가져오는 경쟁에 더 관심이 있다고 했다. 이런 모델이 미국의 주요 AI 기업에 혁신과 가격 경쟁의 압력을 준다고 보는 시각이다. 규제의 목적과 별개로, 칩에서 만들어진 모델을 누가 활용할 수 있는지도 중요하다는 주장이다.
초기값을 만든 장치와 실제 학습 장치가 같다는 가정에 의문을 제기하는 의견도 있었다. 한 사용자는 모델을 먼저 준비한 뒤 나중에 대규모 학습 장비로 옮기는 작업 흐름이 가능하지 않느냐고 물었다. 보고서 역시 가중치의 흔적만으로 이런 이동을 배제할 수 없다고 설명한다.
다른 사용자는 중국 밖 GPU 임대가 가능하다는 점을 다시 강조했다. 답글에서는 비용을 중국 기업이 내더라도 허용되는지, 규제 대상이 정확히 어떤 행위인지에 관한 질문이 이어졌다. 토론의 초점은 GPU에 접근했다는 사실 자체보다 칩의 소재지와 거래 방식으로 옮겨갔다.
클라우드 GPU 이용 경험을 든 사용자는 고객 확인이 간소한 서비스도 있어 원격 임대를 막기 쉽지 않을 것이라고 봤다. 규제가 강화되면 타인의 신원을 빌려 접속하려는 시도와 이를 감시하는 서비스 제공자 사이의 대응이 이어질 수 있다는 예상이다. 다만 이는 이번 모델들이 실제로 그런 방식으로 GPU를 이용했다는 주장이 아니라 향후 집행의 어려움에 관한 의견이다.
수출 통제의 효과를 놓고도 의견이 갈렸다. 한 사용자는 재판매가 여러 단계를 거치는 회색시장이 존재하므로 통제가 실효성이 낮다고 주장했다. 반론은 통제의 목적이 모든 접근을 완전히 막는 데만 있지 않으며, 필요한 장비를 얻는 비용을 높이거나 사업을 지연시킬 수도 있다는 것이었다.
마지막으로 한 사용자는 블랙웰에서 학습된 다른 모델을 증류(기존 모델의 출력을 이용해 새 모델을 학습시키는 방식)해도 이런 흔적이 생길 수 있는지 물었다. 답글에서는 이번 검사가 출력의 유사성이 아니라 가중치의 초기 난수 배열을 추적하므로, 출력에 기반한 증류만으로 같은 배열을 설명하기는 어렵다는 반론이 나왔다. 이는 모델이 무엇을 배웠는지와 가중치가 어디서 시작됐는지를 구별하는 질문이다.
핵심통찰
이번 분석은 공개 모델의 가중치가 성능뿐 아니라 제작 과정의 일부도 드러낼 수 있음을 보여준다. 특히 씨앗값, 작업 배치, 보존된 초기값을 함께 대조하면 기업의 설명이나 내부 문서 없이도 하드웨어 접근을 검증할 단서가 생긴다. 다만 단서가 가리키는 지점은 학습의 시작이다. 앞으로 확인해야 할 것은 초기화에 쓰인 칩이 전체 학습에도 쓰였는지, 그 연산이 어디서 이뤄졌는지다. 두 질문을 분리해야 기술적 발견을 수출 통제 위반이라는 결론과 혼동하지 않는다.
원본: Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs
토론: Hacker News