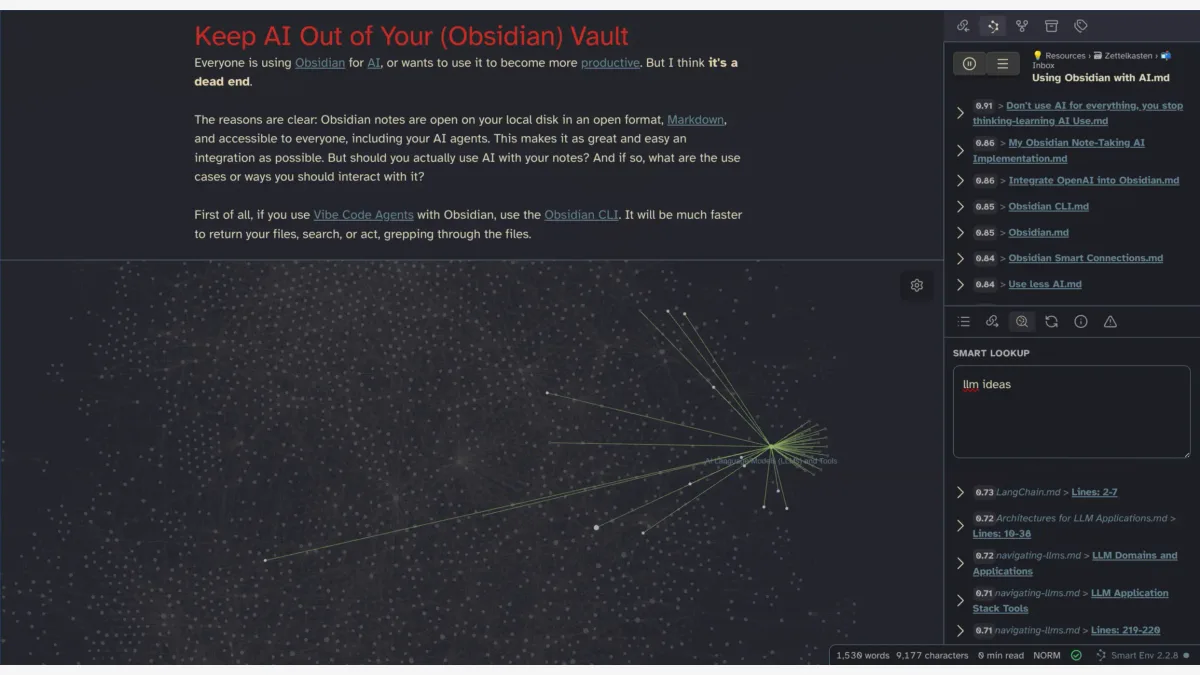
시몬 슈페티(Simon Späti)는 AI가 옵시디언(Obsidian) 노트를 읽는 것과 그 노트를 대신 쓰는 것은 전혀 다른 일이라고 주장한다. 마크다운 파일에 손쉽게 접근하는 AI 에이전트는 검색과 자료 탐색을 도울 수 있지만, 생성한 요약과 연결까지 개인의 볼트(노트를 모아 둔 저장 공간)에 쌓이면 무엇이 자신의 생각인지 흐려진다는 것이다. 노트 앱에 AI를 붙이는 일이 생산성을 높여 준다는 기대가 큰 지금, 그의 글은 노트의 양보다 쓰고 연결하는 과정에서 얻는 사고를 지켜야 한다는 반론을 던진다.
핵심 요약
- 슈페티는 옵시디언의 열린 마크다운 파일이 AI 연동을 쉽게 만들지만, 그 편리함 때문에 생성 문장을 자신의 노트와 섞지 말아야 한다고 주장한다.
- 긴 AI 요약은 나중에 다시 읽을 때 자신의 관심사를 제대로 짚지 못해, 검색 결과를 늘리고 원자료를 다시 읽게 만들 수 있다고 그는 말한다.
- 관련 노트를 찾는 데는 AI를 쓸 수 있지만 태그와 연결을 대신 만들게 하면 노트를 엮으며 생각하는 과정이 사라진다는 것이 그의 기준이다.
- 그는 2만5979개 파일, 총 3.5GB의 볼트에서도 기존 검색 도구로 필요한 내용을 빠르게 찾는다며, AI 도입 전에 정리 방식부터 살펴보라고 권한다.
- 토론에서는 AI가 코드 주석에 근거 없는 설계 의도를 남길 위험과 함께, 종이 노트나 로컬 AI도 각자의 목적에 맞게 쓸 수 있다는 반론이 나왔다.
열려 있는 파일, 쉬워진 AI 연동
옵시디언 노트는 로컬 디스크에 마크다운 형식으로 저장된다. 사용자는 파일을 직접 다룰 수 있고, AI 에이전트도 같은 파일을 읽거나 검색할 수 있다. 슈페티는 이런 구조가 연동에는 큰 장점이라고 인정하면서도, 접근할 수 있다는 사실이 노트 작성을 맡겨도 된다는 뜻은 아니라고 선을 긋는다. 그의 질문은 AI를 볼트에 연결할 수 있는지가 아니라, 연결한 뒤 무엇을 하게 할 것인지다.
그는 AI 코딩 에이전트로 옵시디언 파일을 다룬다면 옵시디언 CLI(명령줄 인터페이스)를 쓰라고 권한다. 파일을 찾고 검색하고 작업하는 데 빠르다는 이유다. 도구로서의 활용 자체를 거부하는 입장은 아니다. 그가 경계하는 지점은 에이전트가 만든 문장을 자신이 오래 보관할 생각의 기록과 구별 없이 섞어 놓는 순간이다.
긴 요약이 볼트를 채울 때
슈페티가 특히 피하려는 것은 AI가 만든 긴 요약을 볼트에 계속 추가하는 방식이다. 시간이 지나면 어느 문장을 직접 썼고 어느 문장을 AI가 만들었는지 기억하기 어려워진다. 그는 이렇게 쌓인 AI 슬롭(성의 없이 대량으로 만들어진 저품질 AI 생성물)이 자신의 생각을 흐리게 하고, 검색할 때도 걸러야 할 잡음을 늘린다고 본다. 직접 적은 노트라면 나중에 내용이 부족해 보이더라도, 당시 그것을 기록하게 만든 관심이나 판단이 남아 있다.
AI 요약을 다시 열어 보았을 때의 경험도 그의 판단에 영향을 줬다. 처음에는 그럴듯해도 정작 자신이 중요하게 여길 대목을 짚어 주지 않아 원자료를 다시 읽게 된다는 것이다. 다만 그는 한두 문장의 짧은 소개까지 문제 삼지는 않는다. 옵시디언 웹 클리퍼(Web Clipper)로 새 노트를 만들 때 짧은 AI 요약을 넣기도 하지만, 생성 문장임을 표시하고 인용 형태로 구분한다. 자신의 생각을 덧붙인 뒤에는 필요 없는 생성 문단을 지운다.
이 구분에는 현재의 자신뿐 아니라 훗날 노트를 읽을 사람도 염두에 둔 판단이 담겨 있다. 노트 한 장의 내용이 맞는지만큼, 누가 어떤 생각으로 적었는지가 중요하다는 것이다. 슈페티에게 AI 요약은 자료에 접근하는 임시 안내문일 수는 있어도, 읽고 판단한 흔적을 대신하는 기록은 아니다. 그래서 짧고 표시된 보조 문장과 볼트를 채우는 대량의 생성 노트를 다르게 취급한다.
관련 노트는 찾되 연결은 직접
슈페티는 관련 노트를 발견하는 고급 탐색을 AI의 유망한 용도로 꼽는다. 자신이 잊고 있던 기록을 찾아 보여 주는 일은 기존 생각을 다시 살피는 출발점이 될 수 있다. 반면 태그를 붙이고 노트 사이의 관계를 자동으로 구성하는 데에는 부정적이다. 그가 말하는 세컨드 브레인(생각과 자료를 기록하고 연결하는 개인 지식 체계)의 힘은 관계의 개수가 아니라, 왜 두 생각을 연결했는지 스스로 아는 데 있다.
AI 실험을 하고 싶다면 별도의 볼트나 데이터베이스를 쓰는 방법도 제안한다. 슈페티 역시 덕DB(DuckDB)로 검색과 군집화 작업을 해 봤지만, 그 결과물을 자신의 노트 체계와 곧바로 섞지는 말라고 권한다. 그의 볼트에는 2만5979개 파일, 총 3.5GB의 자료가 들어 있다. 그럼에도 옴니서치(Omnisearch) 플러그인으로 필요한 내용을 빠르게 찾는다며, 검색의 어려움은 먼저 노트의 조직 방식에서 살펴야 한다고 말한다.
더 복잡한 탐색이 필요할 때는 스마트 커넥션스(Smart Connections) 같은 플러그인으로 벡터·유사도 검색을 더할 수 있다고 설명한다. 슈페티 자신도 이 도구나 그래프 애널리시스(Graph Analysis)를 활용한다. 다만 민감한 노트를 외부에 올리고 싶지 않아, 더 강력한 로컬 모델을 통한 활용은 앞으로 검토할 가능성으로 남겨 두고 있다. 검색 능력을 넓히는 일과 생각의 연결을 기계에 맡기는 일을 구별하는 셈이다.
내일의 AI가 읽을 오늘의 노트
슈페티는 앞으로 자신의 노트가 AI를 위한 프롬프트나 참고 자료가 될 수 있다고 본다. 그렇기 때문에 오히려 오늘의 기록은 사람이 직접 길러 낸 지식이어야 한다는 주장이다. AI가 생성한 평균적인 내용으로 개인의 노트가 채워지면, 기록마다 담겨 있던 확신과 선택이 옅어진다고 우려한다. 그는 인간이 선별하고 축적한 지식의 가치가 AI를 위해서도 중요하며, 그 지식을 만든 사람에게 돌아갈 경제적 보상 방식도 필요하다고 덧붙인다.
클로드 코드(Claude Code) 같은 에이전트가 노트 체계를 만들고 연결까지 완성해 주는 경우에도 같은 질문이 남는다. 결과물에서 정보를 꺼내 쓸 수는 있지만, 그 체계를 자신의 사고 과정이라고 부를 수 있느냐는 것이다. 슈페티는 노트를 쓰고 관계를 만드는 일을 줄여야 할 비효율로 보지 않는다. 한 생각을 적고 다른 기록과 연결하는 동안 이해하고 배우는 일이 벌어진다고 보기 때문이다.
그가 중시하는 것은 앱 자체보다 파일 안에 담긴 자신의 판단이다. 외부 도구가 만든 연결이 도움이 될 때도 있겠지만, 어떤 계기로 두 노트를 이어 붙였는지 직접 떠올릴 수 있는 연결과는 쓰임새가 다르다. 개인 지식 체계의 목적이 정보 회수에만 있다면 자동화의 이점이 크다. 반대로 그 체계가 새로운 생각을 만드는 장소라면, 자동화가 없애는 수고도 그 목적의 일부가 된다.
AI가 제안한 생각을 끝맺기 어려운 이유
슈페티는 오마키(Omarchy) 플러그인 작업과 리눅스 최적화·장애 감지에는 클로드 코드를 많이 쓴다고 밝힌다. 그러나 글을 쓰고 노트를 정리할 때, 특히 독자적인 생각을 찾아 끝까지 밀고 가는 일에는 쓰지 않는다. AI가 건넨 아이디어는 자신의 관심과 경험에서 출발한 생각보다 완성하기 어렵다는 이유다. 그는 빠짐없이 다루지 못하더라도 직접 쓰고 공상하며 자신의 생각이 향하는 방향을 따라가는 편을 택한다.
안드레이 카르파티(Andrej Karpathy)의 LLM 지식 자동 연구 사례를 보는 시각도 이 기준과 닿아 있다. 자동으로 조사 결과와 연결을 만드는 일은 흥미롭고 유용할 수 있지만, 배우고 자신만의 지식 체계를 가꾸는 목적에는 맞지 않는다고 슈페티는 본다. 그가 몇 년 전 만든 노트 사이의 연결에서 새 아이디어를 얻는 것은 연결 결과만 다시 보기 때문이 아니다. 과거의 자신이 무엇을 보고 두 기록을 묶었는지 돌아볼 수 있기 때문이다.
그렇다고 모든 AI 생성 노트를 버려야 한다는 뜻은 아니다. 슈페티는 티아고 포르테(Tiago Forte)의 파라(PARA) 방식처럼 별도 폴더에 생성 노트를 모으고, 검색에서 숨기거나 원래 노트와 구별하는 방안을 제시한다. AI로 음성을 글로 옮기는 방법도 상황에 따라 쓸 수 있다고 본다. 다만 자신은 말할 때보다 쓸 때 생각을 더 정리하고, 음성 인식 결과를 고치는 수고도 들어 직접 타이핑하는 편을 선호한다.
커뮤니티 의견
한 사용자는 비슷한 문제가 코드베이스에서도 벌어진다고 했다. 클로드가 상세한 주석을 쓰면서 실제로 확인되지 않은 설계 의도와 결정을 사실처럼 설명하고, 이후 작업에서 그 주석을 다시 읽어 확정된 내용으로 취급한다는 것이다. 이에 별도의 기준 사양 문서를 먼저 마련하자는 제안도 답글로 나왔다.
다른 사용자는 세컨드 브레인을 굳이 만들 필요가 있는지 물었다. 자신은 관심사를 계속 생각하면서 많은 아이디어를 떠올리고, 쓸모없는 것들은 잊어버리는 편이라고 설명했다. AI는 시험해 볼 수 있는 아이디어를 걸러 주기도 하지만, 동료와의 대화보다 잡음이 많다고 평가했다.
아이디어를 누가 냈다고 느끼느냐가 실행에 영향을 준다는 의견도 있었다. 한 사용자는 관리자가 제안을 자신의 생각처럼 받아들였을 때 실행할 가능성이 커지는 모습을 AI가 제안한 아이디어의 문제와 비교했다. 다만 이 방식에는 실제로 처음 제안한 사람이 공로를 인정받지 못한다는 문제도 따른다고 짚었다.
옵시디언 자체의 필요성을 묻는 사용자도 있었다. 떠오르는 생각은 종이 수첩에 적고 디지털 노트에 보관하면 충분하다며 세컨드 브레인 열풍을 의심했다. 답글에서는 종이나 디지털 파일 모두 다시 읽을 수 있으면 노트의 역할을 한다는 의견과, 링크·인용·이미지를 엮는 작업은 종이보다 디지털 노트가 편하다는 경험이 함께 나왔다.
한 사용자는 AI가 제안한 생각을 끝맺기 어려운 까닭을 문제의 소유권에서 찾았다. 코딩 에이전트가 정해진 문제의 코드를 작성할 수는 있어도, 모호한 상황을 해석하고 무엇을 풀어야 할지 정하는 책임은 사람에게 남는다는 주장이다. AI가 이미 내려 둔 임의의 판단이 사용자의 이해나 실제 상황과 어긋나면, 이어받는 데도 시간이 든다고 설명했다.
AI가 창작을 했다고 생각할 때 과제의 의미와 투입 노력이 줄어든다는 연구를 떠올린 사용자도 있었다. 이 댓글은 연구 링크를 공유하며, 결과물을 얻는 것과 그 일을 자신의 과제로 받아들이는 것이 다를 수 있다는 논점에 힘을 보탰다.
반대로 로컬 AI를 개인 노트에 적용하는 일을 즐긴다는 사용자도 있었다. 일기와 연구 기록이 뒤섞인 긴 하루의 기록을 로컬 모델에 넣고 요약 결과를 살펴보는 과정이 재미있었다고 했다. 일기에는 남에게 보여 주고 싶지 않은 내용이나 비밀번호가 들어갈 때도 있어, 작업은 로컬에 남겨 두겠다고 밝혔다.
마지막으로 한 사용자는 노트를 쓰는 행위 자체가 학습이라고 강조했다. 내용을 문장으로 옮기다 보면 무엇을 더 이해해야 설명할 수 있는지 깨닫고, 관련 노트를 직접 찾아 연결할 때도 새로운 생각이 생긴다는 것이다. AI가 글과 링크를 대신 만들면 결과물은 남겠지만 그 과정에서 얻는 배움은 줄어든다고 봤다.
핵심 통찰
슈페티의 주장은 노트에서 AI를 완전히 몰아내자는 말보다, 검색과 사고의 경계를 사용자가 정하자는 제안에 가깝다. AI가 잊힌 기록을 찾아 주고 생성 문장을 별도로 표시한다면 볼트의 쓰임새는 넓어진다. 하지만 요약과 연결을 무심코 축적하면 훗날 사람과 AI 모두 그 기록이 어떤 판단에서 나왔는지 읽기 어려워진다. 지켜볼 것은 AI가 노트를 얼마나 많이 생산하느냐가 아니라, 사용자가 노트를 다시 펼쳤을 때 자신의 생각을 이어 갈 수 있느냐다.
원본: Keep AI Out of Your (Obsidian) Vault
토론: Hacker News