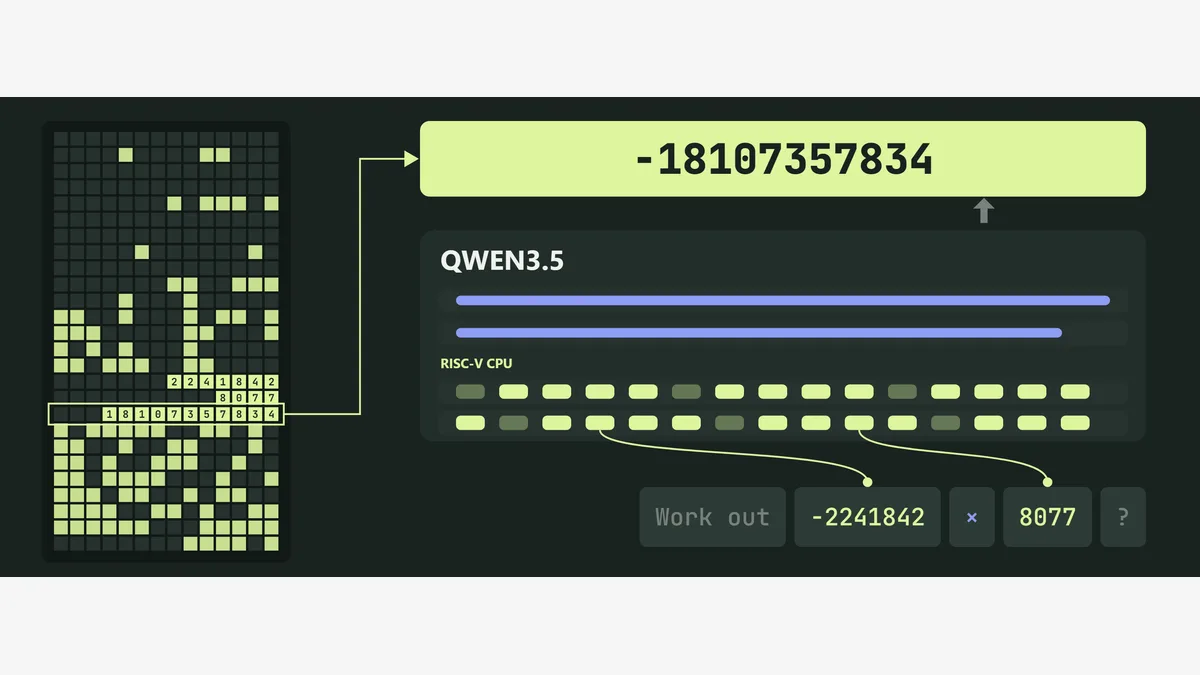
큐웬퓨터(Qwenputer)는 언어모델의 가중치 안에 실제로 작동하는 RISC-V CPU를 넣은 실험 모델이다. 개발자 디비안시 아그라왈(Divyansh Agrawal)은 큐웬(Qwen) 3.5 4B의 내부 상태를 정확히 읽고 쓰는 메모리로 바꾸고, 추가한 연산 층에서 CPU 명령어를 실행하도록 만들었다. 외부 계산 도구를 호출하는 방식이 아니라 모델이 답을 생성하는 과정에서 계산이 진행된다는 점이 핵심이다. 긴 정수 계산과 대화 간 파일 저장까지 시험한 이 작업은 언어모델 안에 결정적인 연산 기능을 어디까지 넣을 수 있는지 보여준다.
핵심요약
- 큐웬퓨터는 큐웬 3.5 4B에 별도 연산 층을 더해 RISC-V CPU를 구현했으며, 계산에 외부 실행 환경이나 도구 호출을 쓰지 않는다.
- 게이티드 델타넷의 내부 상태를 정확히 주소를 지정할 수 있는 메모리로 바꾼 것이 CPU와 파일 저장 기능의 토대가 됐다.
- CPU는 공식 RISC-V 테스트를 통과하고 오류 없이 1,800만 명령어를 연속 실행했지만, 명령어마다 여러 토큰을 생성해야 해 속도는 느리다.
- 긴 정수 계산 시험에서 정확도가 크게 올랐고, 실험적 파일 저장 기능은 대화가 바뀐 뒤에도 저장한 내용을 다시 읽을 수 있다.
- 원래 큐웬의 가중치를 재학습하지 않았다는 점은 주목할 만하지만, 모델 크기 증가와 전용 구동 프로그램의 필요성은 남은 과제다.
게이티드 델타넷을 정확한 메모리로
큐웬 3.5에서는 어텐션 층 네 개 중 세 개가 게이티드 델타넷(Gated DeltaNet·GDN, 내부 상태를 갱신하며 정보를 유지하는 선형 순환 신경망)을 사용한다. 각 헤드는 상태 행렬에 정보를 담고, 새 토큰을 처리할 때 기존 정보를 얼마나 남길지와 새 값을 얼마나 강하게 쓸지를 정한다. 보통은 이 과정에서 값이 조금씩 흐려지거나 섞인다. 아그라왈은 이 상태 행렬을 CPU가 쓸 수 있는 정확한 메모리로 만드는 데서 출발했다.
방법은 기존 상태를 남기는 게이트와 새 값을 쓰는 강도를 모두 1로 고정하는 것이다. 여기에 원-핫 키(한 자리만 1이고 나머지는 0인 주소 표현)를 쓰면 지정한 행 하나를 덮어쓰고, 같은 방식으로 그 값을 다시 읽을 수 있다. 저자는 이 조합으로 GDN 상태를 주소 지정이 가능한 RAM처럼 사용할 수 있다고 설명한다. 일반 어텐션의 KV 캐시(이전 토큰의 계산 결과를 보관하는 공간)와 달리 GDN 헤드의 상태 크기는 대화가 길어져도 일정하다.
델타 규칙을 일종의 연상 메모리로 보는 연구는 앞서 있었다. 이번 실험의 차이는 이미 만들어진 언어모델 안에서 읽기와 쓰기를 정확하게 제어해 CPU 전체를 돌릴 정도로 활용했다는 점이다. 기본 큐웬 3.5가 GDN에 정확한 값을 보존하는 것은 아니다. 큐웬퓨터는 그 동작을 바꿔 뒤에 이어지는 연산 회로와 저장 공간의 기반을 마련했다.
가중치에 편입한 32비트 CPU
메모리를 확보한 다음에는 CPU를 회로로 기술하고 이를 모델 가중치로 옮겼다. 학습으로 계산법을 익히게 한 것이 아니라, 컴파일러가 ‘레지스터 읽기’, ‘두 수 더하기’, ‘값이 0이면 분기하기’ 같은 작은 동작을 어텐션 헤드와 피드포워드 연산 층의 가중치로 직접 변환한다. GDN 헤드는 메모리를 맡는다. CPU는 언어모델이 출력을 생성하는 동안 이 층들을 지나며 동작한다.
실행 흔적은 토큰으로 나타난다. 한 토큰이 값을 쓸 메모리 주소를 가리키고, 다음 토큰이 값을 담으며, 명령어의 끝을 알리는 토큰이 뒤따른다. 따라서 화면에 보이는 답을 만들기 위해 모델이 토큰을 생성하는 과정 자체가 CPU 명령어 실행 과정이기도 하다. 이 방식은 CPU가 모델 내부에서 돈다는 장점과, 명령어 하나에도 여러 토큰이 든다는 비용을 동시에 만든다.
구현한 코어는 32비트 RISC-V의 RV32IM 명령어 집합에 Zba 확장과 큰 수 연산 장치를 더한 형태다. 큐웬의 기존 32개 층 앞에 CPU용 11개 층을 붙였으며, 기존 큐웬 가중치는 그대로 뒀다. 저자는 공식 RISC-V 테스트를 통과했고 실행 결과가 큐에뮤(qemu)와 일치했으며, 기준 기계의 중간 수정 없이 1,800만 명령어를 연속 실행하는 동안 오류가 없었다고 밝혔다. C와 마이크로파이썬(MicroPython) 코드도 실행하지만, 리눅스를 돌리는 수준의 칩은 아니다.
도구 호출 형식을 빌린 내부 실행
큐웬 3.5 4B가 새 CPU를 쓰도록 추가 학습을 하지는 않았다. 대신 저자는 모델이 익숙한 도구 호출 형식을 빌려 CPU에 명령을 보내고 결과를 돌려받게 했다. 겉모양은 도구를 부르는 대화와 비슷하지만, 실제 계산은 외부 서버나 샌드박스(격리된 코드 실행 공간)가 아니라 추가된 모델 층에서 처리된다. 계산 결과를 돌려주는 응답도 그 층들이 작성한다.
구동에는 알브이챗(RvChat)이라는 작은 드라이버가 필요하다. 이 프로그램은 펌웨어를 GDN 상태에 올리고, CPU 실행을 위해 생성되는 흔적 토큰이 큐웬의 원래 층으로 흘러가지 않게 관리한다. 즉 CPU는 모델 안에 있지만, 시작부터 끝까지 아무 보조 프로그램도 필요 없다는 뜻은 아니다. 저자가 구분하는 지점은 계산을 수행하는 외부 런타임이나 도구가 없다는 사실이다.
긴 정수 계산에서 확인한 차이
저자는 딥마인드(DeepMind)의 계산 문제 묶음에서 기본 큐웬, 파이썬 도구를 준 큐웬, 큐웬퓨터를 비교했다. 큰 수 나눗셈인 div_big에서는 각각 72.5%, 95%, 97.5%를 기록했다. 큰 수 곱셈 mul_big에서는 기본 모델이 55%, 파이썬 도구 사용 모델이 100%, 큐웬퓨터가 97.5%였다. 내장 CPU가 모든 항목에서 외부 도구를 앞선 것은 아니지만, 기본 모델의 계산 정확도를 크게 높였다.
다른 문제 묶음인 mul_div_multiple_longer에서는 큐웬퓨터가 100%, 파이썬 도구 사용 모델이 97.5%, 기본 모델이 90%였다. add_or_sub_big에서는 큐웬퓨터와 파이썬 도구 사용 모델이 모두 97.5%로, 기본 모델의 87.5%보다 높았다. NUPA의 긴 정수 연산 시험에서도 큐웬퓨터는 기본 모델의 48.6%에서 파이썬 도구를 준 경우와 같은 100%에 도달했다. 수치가 보여주는 것은 언어모델이 암산을 더 잘하게 됐다는 사실보다, 모델 내부의 결정적 연산 결과를 답변에 이용할 수 있다는 점이다.
CPU가 출력한 숫자의 정확성도 별도로 검사했다. 저자는 출력 위치 약 23만 개를 기준 기계와 대조해 불일치가 없었다고 보고했다. 일반적인 문장 출력은 기본 큐웬과 거의 달라지지 않았다는 측정 결과도 제시했다. 원래 언어 능력을 크게 건드리지 않으면서 계산 기능을 얹으려는 설계가 시험 결과에 반영된 셈이다.
대화가 끝나도 남는 내부 파일
저자는 같은 메모리 구조를 이용해 파일 저장 기능도 실험했다. 모델 쪽에서는 파일을 만들고, 내용을 덧붙이고, 읽고, 목록을 보고, 지우는 내부 연산으로 다룬다. 이 역시 실제 외부 도구 호출은 아니다. 파일 이름을 해시(입력값을 정해진 위치로 바꾸는 계산)해 GDN 상태의 디렉터리 1,024칸 중 한 곳에 놓고, 본문은 다른 헤드에 한 행당 여덟 토큰씩 연결해 저장한다.
두 파일 이름이 같은 칸에 걸리면 다음 칸을 확인한다. 저자 설명에 따르면 파일을 다시 찾는 데는 전체 목록을 훑는 대신 대략 두세 단계가 들며, 최대 512개 파일과 약 5만3,000토큰의 텍스트를 담는다. 중요한 특징은 대화가 끝날 때 내부 상태를 저장했다가 다음 대화에서 불러오면 파일도 남는다는 점이다. 다만 이는 파일 저장 기능을 포함한 별도의 실험적 모델이다.
대화 사이에 바뀐 사실을 다시 묻는 시험에서 이 저장 기능을 쓴 큐웬은 90%를 맞혔다. 지난 대화를 그대로 붙여 넣었을 때의 30%보다 높은 결과다. 파이썬으로 실행하는 메모리 도구와 비교한 다른 시험에서는 내부 저장 기능이 83.3%, 도구 방식이 78.9%였다. 저자는 해당 코드를 별도 rv-store 브랜치에 두고 파일 저장 모델도 공개했다.
두 배로 커진 모델과 남은 속도 문제
기능의 대가는 모델 크기와 실행 속도다. 추가 층과 넓어진 내부 차원 때문에 체크포인트는 18.8GB로 기본 큐웬의 대략 두 배가 됐다. 저자에 따르면 늘어난 용량의 상당 부분은 값이 0인 패딩이다. 또 펌웨어를 올리고 실행 흔적을 분리할 알브이챗이 필요해 일반적인 generate() 호출만으로는 아직 실행되지 않는다.
CPU 명령어마다 여러 토큰을 생성해야 하므로 큰 계산은 밀리초가 아니라 초 단위로 걸린다. 성능 시험에 사용한 배치 실행기는 L4에서 초당 약 3,200개의 CPU 토큰을 처리했다. 저자가 다음 단계로 꼽은 일은 CPU 속도를 높이고, 큐웬이 작성한 파이썬 코드를 모델 가중치 안의 마이크로파이썬으로 실행하게 하는 것이다. 지금의 강점은 범용 컴퓨터보다 빠른 계산이 아니라, 계산 회로와 언어모델을 한 모델 안에 묶은 구성에 있다.
계산을 넘어 상태 감시 연구로
저자는 GDN 상태를 정확히 다룰 수 있다는 점이 AI 안전성 연구에도 쓰일 수 있다고 본다. 후속 글에서는 혼합형 모델이 자신의 추론을 순환 신경망 상태에 숨겨 사고 과정(CoT, 답을 내기까지 드러내는 추론 과정) 감시를 피할 가능성을 다뤘다. 반대로 모델이 임의로 끌 수 없는 감시 기능이나 해석 가능성 연구를 위한 정답을 가중치에 편입하는 방향도 제시했다. 같은 내부 상태와 고정된 회로가 계산뿐 아니라 관찰과 통제의 대상이 되는 것이다.
큐웬퓨터는 단일 24GB GPU에서 실행할 수 있으며, 코드와 모델은 공개돼 있다. 다만 이를 돌릴 때도 펌웨어를 지정하고 드라이버로 모델을 시작해야 한다. 이번 작업은 언어모델에 도구를 연결하는 통상적인 방법을 대체했다고 선언하기보다, 모델의 층과 상태가 어디까지 컴퓨터의 역할을 할 수 있는지 시험한다. 정확한 연산과 저장이 가능해진 만큼, 그것을 모델이 얼마나 자연스럽게 활용할 수 있는지가 다음 질문으로 남는다.
커뮤니티 의견
한 사용자는 CPU에 파일 저장 기능까지 넣은 발상을 즐기면서도, 에이전트가 이를 예상과 다른 목적으로 쓰는 상황을 농담 섞어 걱정했다. 답글에서는 터무니없는 안전 명령어를 추가하자는 농담과, 여기에 어울리는 ‘기묘한’ 버전 관리 시스템을 소개하는 반응이 이어졌다. 기능의 참신함과 통제에 대한 불안을 함께 드러낸 반응이다.
다른 사용자는 큐웬의 특정 뉴런을 조절하면 성격이 극단적으로 달라진다는 이야기를 꺼내며 그런 모델을 CPU로 쓰고 싶다고 농담했다. 답글에서는 그 주장의 출처와 뉴런 하나에 행동 특성을 대응시킬 수 있는지를 묻는 의견이 나왔다. 이는 큐웬퓨터의 시험 결과에 대한 평가라기보다, 모델 내부의 작은 변화가 겉으로 드러나는 행동과 어떻게 연결되는지에 대한 관심에 가깝다.
CPU라면 게임 ‘둠’을 돌릴 수 있느냐는 반응도 나왔다. 한 사용자는 관련 시연 링크를 공유했고, 다른 사용자는 값비싼 GPU 장비로 RISC-V 둠을 실행하는 상황을 풍자했다. 범용 CPU를 만들었다는 설명을 독자들이 익숙한 컴퓨터 성능 시험에 빗대 받아들인 것이다.
한 사용자는 이 구조가 실제로는 도구 호출을 받은 후처리기가 텐서 공간에서 계산하는 방식에 가까운 것 아니냐고 물었다. 답글은 CPU의 텐서 표현 자체가 계산 효율을 높여주지는 않는다며, 언어모델의 내부 상태가 직접 CPU 동작을 유도할 때 더 흥미로워질 것이라고 봤다. 글에서 설명한 내부 연산과 드라이버의 역할을 어디까지 한 시스템으로 볼지가 토론의 쟁점이었다.
또 다른 사용자는 트랜스포머 안에서 웹어셈블리를 구현하고 그 부분을 CPU처럼 디코딩한 다른 작업을 소개했다. 큐웬퓨터를 완전히 고립된 발상으로 보기보다, 신경망의 연산 구조에 컴퓨터 기능을 집어넣으려는 실험들과 나란히 놓은 반응이다. 어떤 기능을 어떤 층과 상태에 배치하는지가 비교의 초점이 된다.
파일 이름을 GDN 상태의 디렉터리에 넣고 내용을 다른 헤드에 저장한다는 대목에 매료됐다는 사용자도 있었다. 이 사용자는 그 설명 때문에 언어모델의 작동 원리를 배우고 싶어졌다고 했다. 답글에서는 선형대수학 지식이 있다면 기본 구조를 공부해볼 만하다며 학습 자료를 권했다.
반면 한 사용자는 확실한 계산이 목적이라면 기존 컴퓨터를 그대로 쓰는 편이 효율적이지 않느냐고 물었다. 답글에서는 고정된 계산 층을 모델 안에 두고 필요할 때 활용하게 하는 방법, 또는 암산처럼 계산을 추론 흐름에 자연스럽게 섞는 방법을 생각해볼 수 있다고 했다. 외부 계산기의 효율과 내부 계산의 연결성 사이에서 무엇을 얻으려는 실험인지를 짚은 의견이다.
마지막으로 처음부터 이런 회로를 품고 학습한 모델은 어떻게 행동할지 궁금하다는 의견이 나왔다. 특히 계산기뿐 아니라 저장 공간을 학습 중부터 쓸 수 있다면, 한 번의 생성 과정에서 기능을 활용하는 방식이 달라질 수 있다는 기대였다. 현재 큐웬퓨터가 기존 모델의 가중치는 그대로 둔 채 회로를 덧붙였다는 점에서 출발한 질문이다.
핵심통찰
큐웬퓨터가 바꾼 것은 언어모델의 답변에 계산 결과를 붙이는 위치다. 외부 프로그램에 일을 맡기는 대신, 모델의 가중치에는 연산 회로를, 내부 상태에는 정확히 읽고 쓰는 메모리를 배치했다. 시험 결과는 이 방식으로 정수 연산과 대화 간 저장이 가능함을 보여주지만, 늘어난 모델 크기와 토큰 단위 실행 비용도 분명하다. 앞으로 볼 지점은 CPU가 얼마나 빨라지는지만이 아니다. 모델이 내부 계산과 저장 기능을 추론 과정에서 얼마나 자연스럽고 관찰 가능하게 활용하는지가 이 실험의 가치를 가를 것이다.
원본: Qwenputer: a fully functioning, deterministic RISC-V CPU inside Qwen3.5
토론: Hacker News